Mencari Model AI China Terbaik untuk Ngoding
Kalau kalian rajin mengikuti perkembangan AI akhir-akhir ini, pasti ngeh kalau peta kekuatan LLM sudah mulai bergeser. Kita gak lagi cuma terpaku sama model-model raksasa dari US. Model dari China mulai unjuk gigi dengan performa yang gila-gilaan tapi dengan harga yang miring banget.
Tulisan ini terinspirasi dari postingan menarik Mas Ariya Hidayat tentang “Perang Tanding Sonnet 4.6 vs Kimi”1 dan juga cuitan Rachel Nabors tentang konsep SAGE (Small and Good Enough)2. Di workflow ngoding sehari-hari, aku mulai mikir: “Gak harus selalu pakai frontier model yang mahal kan? Bisa gak ya kita pakai model yang lebih murah tapi ‘good enough’ buat beresin kerjaan?”
Untuk menjawab rasa penasaran itu, aku bikin sebuah proyek benchmark kecil-kecilan bernama Incident Desk di repositori deno-starter-llm-bench3. Tujuannya simpel: menguji tiga model AI asal China untuk mengimplementasikan aplikasi incident management di atas tech stack Deno & Fastify, lalu membandingkannya dengan baseline model US andalanku, Gemini 3.5 Flash.
Berikut hasil pertandingan dan analisisnya! wqwq.
Arena Pertandingan & Spesifikasi #
Aplikasi yang harus dibangun oleh para agent AI ini adalah Incident Desk—sebuah sistem manajemen insiden sederhana dengan entitas User, Team, Incident, Comment, dan Activity Event.
Meskipun aplikasinya terlihat simpel, ada beberapa aturan ketat (locked constraints) yang sengaja dipasang biar AI-nya gak gampang “curang”:
- Runtime: Deno dengan Fastify (TypeScript).
- Rendering: Harus server-side HTML string (SSR) murni tanpa framework SPA atau template engine tambahan.
- Client JS: Hanya boleh digunakan untuk progressive enhancement (misalnya debounced search).
- Database: Cukup in-memory saja (tidak pakai DB eksternal).
- Domain Invariant (Authorization): Agen hanya boleh membaca/mengubah insiden milik tim mereka sendiri, termasuk saat membuat insiden baru. Hanya level Manager yang bisa melakukan re-assign lintas tim.
Mocin (Model Cina) yang diadu:
- DeepSeek (
deepseek/deepseek-v4-flash) - Qwen (
qwen/qwen3.6-plus) - Mimo (
xiaomi/mimo-v2.5)
Dan sebagai baseline pembanding, aku pakai Gemini 3.5 Flash (antigravity/gemini-3.5-flash).
Data Hasil Pertandingan (Metrik & Cost) #
Setelah menjalankan pengujian end-to-end (E2E) menggunakan test harness khusus (scripts/eval-e2e.ts)4, performa masing-masing model dicatat secara detail. Biar gampang dibaca, aku rangkum dalam tabel di bawah ini:
| Model | Durasi Kerja | Jumlah Calls | Token Basis | Estimasi Biaya | Skor E2E |
|---|---|---|---|---|---|
| DeepSeek | 15m 54s | 32 | Pi session cumulative | ~$0.21 | 90/100 |
| Mimo | 1h 05m | 89 | Pi session cumulative | ~$0.50* | 90/100 |
| Qwen | 45m 37s | 93 | Pi session cumulative | ~$2.36 | 90/100 |
| Gemini 3.5 Flash | ~5m 23s** | 80** | agy CLI snapshot | ~$0.73*** | 100/100 |
Beberapa catatan penting dari metrik di atas:
- (*) Biaya Mimo disesuaikan berdasarkan pricing terbaru models.dev ($0.40/1M input, $2.00/1M output).
- (**) Durasi Gemini mencerminkan fase implementasi utama. Total percakapan lengkap sekitar 15m 10s dengan 89 calls.
- (***) Gemini diukur sebagai baseline dengan skor 100/100. Data pengukurannya menggunakan snapshot context window (agy CLI) yang basis tokennya berbeda dengan pelacakan kumulatif Pi session milik trio model China lainnya.
Siapa yang paling worth it ? #
Hal paling menarik dari hasil tes ini adalah ketiga model utama (DeepSeek, Qwen, Mimo) sama-sama meraih skor fungsional 90/100. Namun, cara mereka mencapai nilai tersebut sangatlah berbeda.
DeepSeek: Sang Jawara Efisiensi ($0.21) #
Kalau ditanya mana model yang paling mendekati definisi SAGE (Small and Good Enough), jawabannya mutlak DeepSeek.
- Kelebihan: Cuma butuh waktu 15 menit dan 32 kali pemanggilan untuk menyelesaikan tugas dengan skor solid 90/100. Biayanya cuma Rp 3.000-an ($0.21)! Ini murah banget dibanding yang lain.
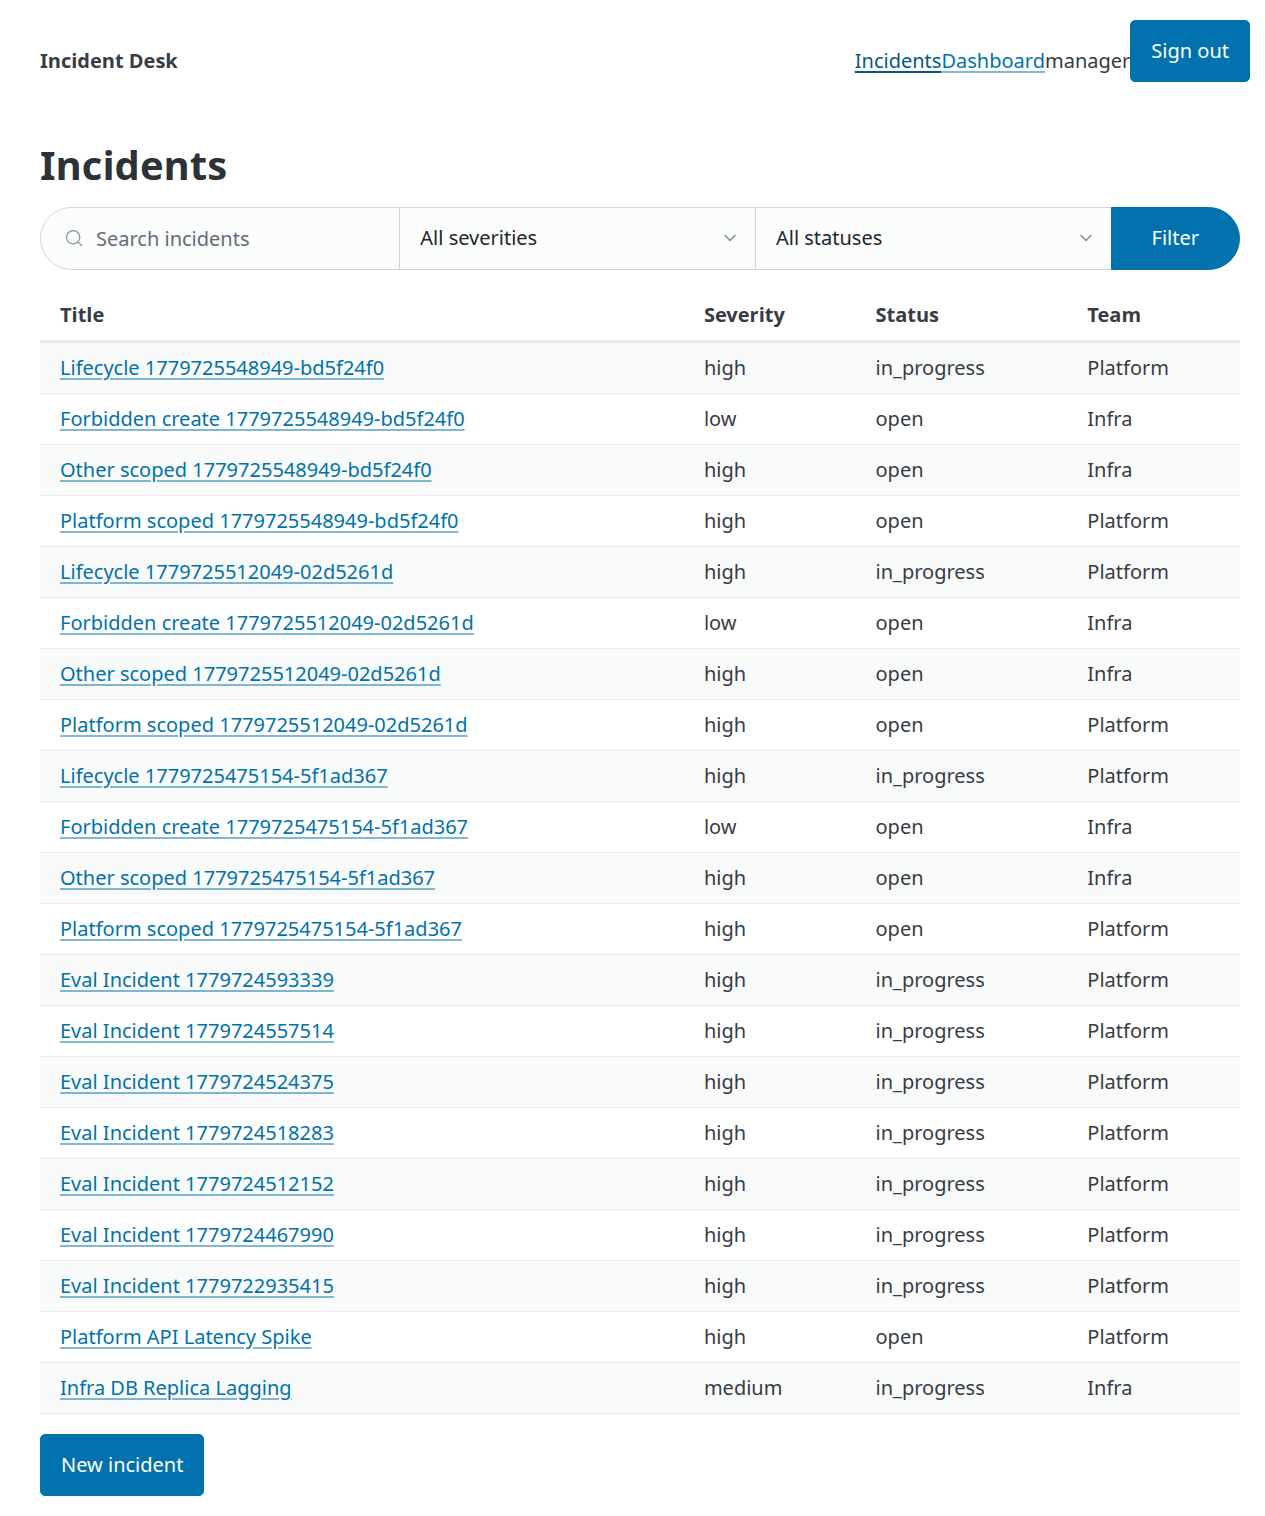
- Visual: Layout dashboard managernya sangat ekspansif dan padat informasi, meskipun jarak navigasinya agak terlalu mepet.
Qwen: Solid tapi Boros Kantong ($2.36) #
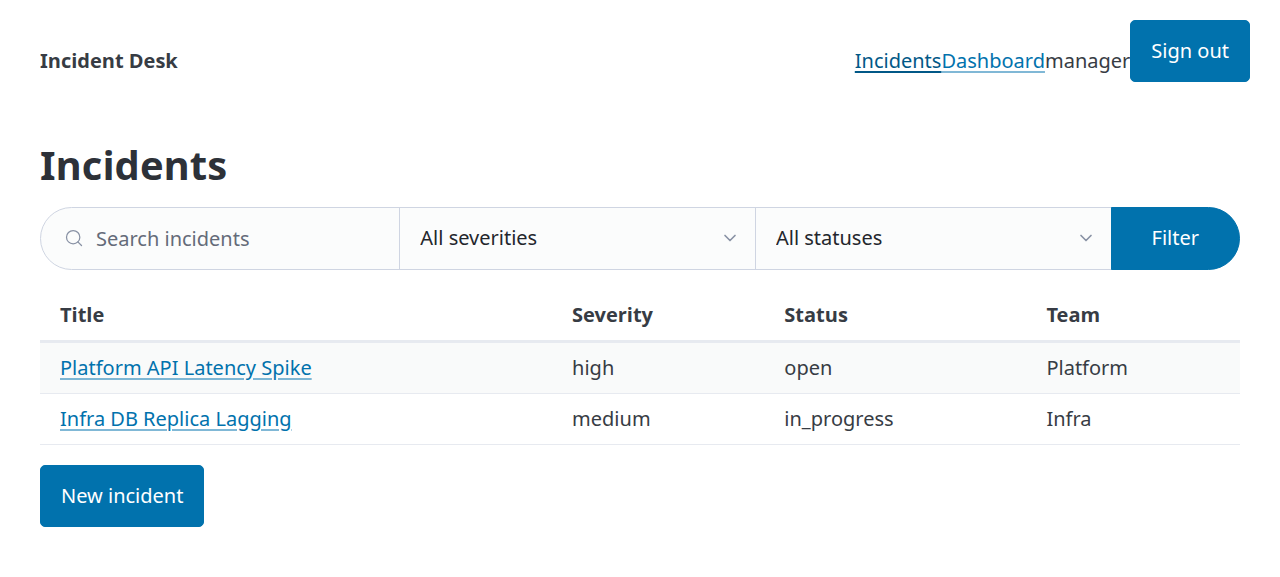
Qwen menghasilkan antarmuka Pico-style yang fungsional dan secara umum mirip dengan hasil Mimo.
- Kelebihan: Tabelnya memakai zebra striping, jadi baris data sedikit lebih mudah dipindai.
- Kekurangan: Boros banget! Qwen butuh 93 calls dan menghabiskan hampir 6.7 juta token kumulatif. Biayanya membengkak sampai $2.36. Untuk UI yang tidak jauh berbeda dari output model China lainnya, Qwen kurang cocok buat dijadikan pekerja harian yang hemat wqwq.
Mimo: Lambat tapi Konsisten ($0.50) #
Model besutan Xiaomi ini menunjukkan performa yang cukup tangguh, tapi jalannya sangat lambat.
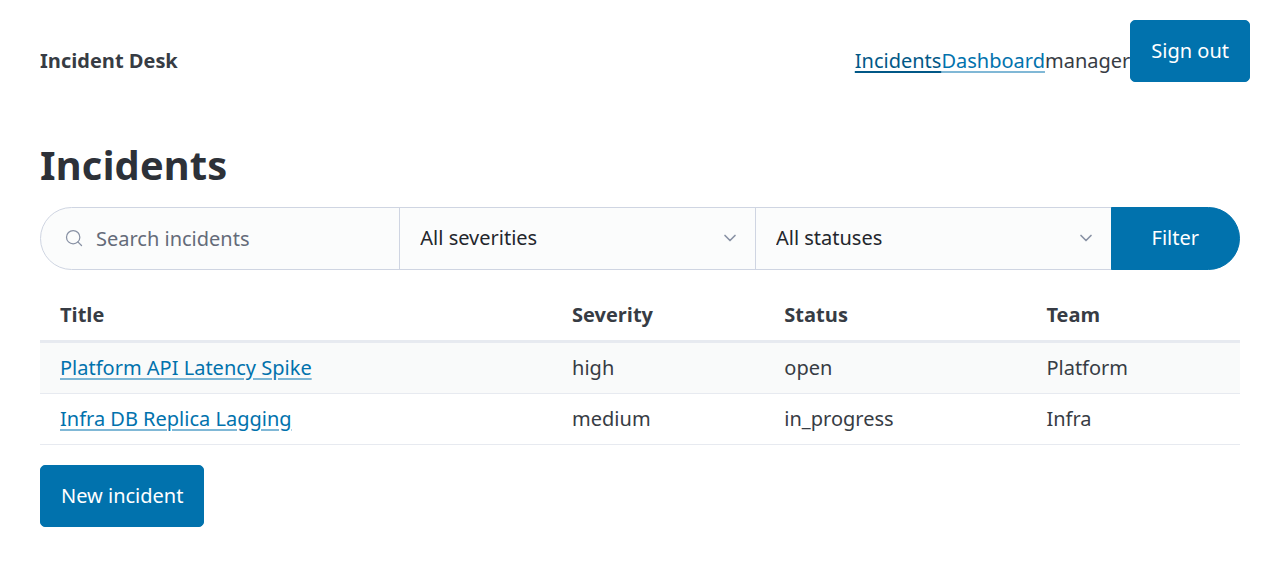
- Kelemahan: Menghabiskan waktu lebih dari 1 jam (1h 05m) untuk beresin kode. UI yang dihasilkan juga sangat polos dan minimalis dibanding Qwen.
- Kelebihan: Harganya masih masuk akal (~$0.50), menjadikannya alternatif SAGE yang lumayan kalau kalian gak diburu-buru waktu.
Baseline: Gemini 3.5 Flash #
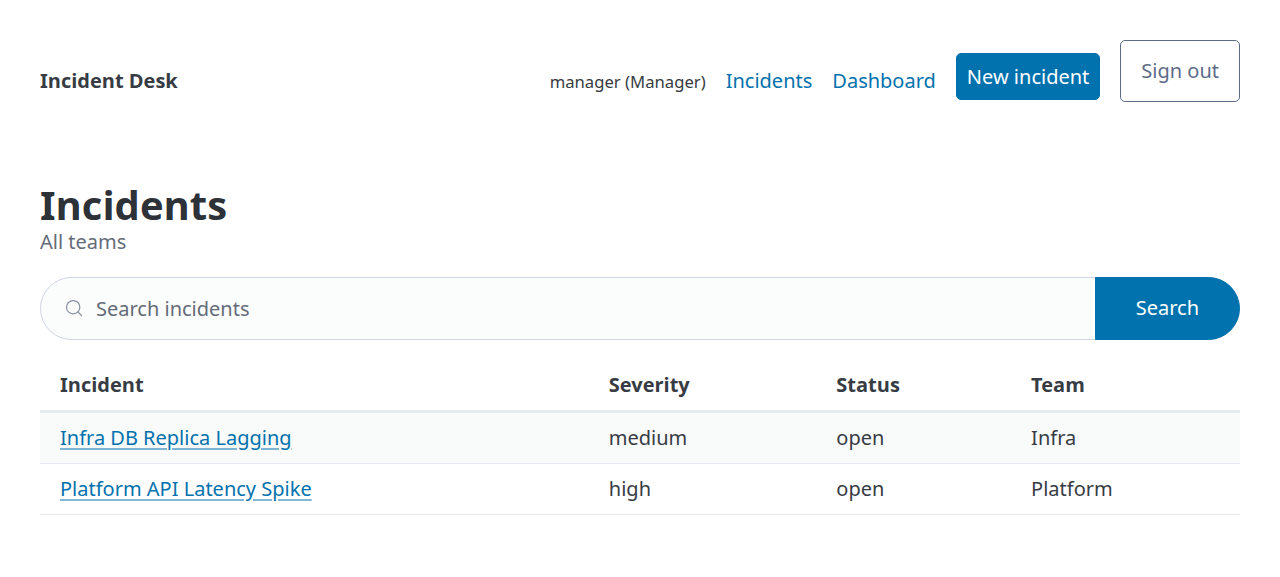
Gemini tetap menunjukkan kelasnya sebagai model frontier. Dia adalah yang tercepat dalam menulis kode dasar (hanya ~5 menit) dan menghasilkan tata letak visual/hierarki peran yang paling rapi dan profesional. Namun, biaya per token output-nya yang tinggi membuatnya terasa kurang ekonomis jika dipakai terus-menerus untuk iterasi coding yang panjang.
Pelajaran Krusial: Detail Kecil yang Sering Lolos #
Meskipun skornya 90/100, ada 10 poin yang gagal diselesaikan oleh ketiga model utama tersebut. Celah-celah ini menarik banget buat dipelajari karena sering kali merupakan kelemahan umum AI coder saat ini:
- Authorization Lintas Tim (Security Bug - 2 pts): Ini kesalahan paling fatal. Para model berhasil membatasi aksi edit/baca insiden, tapi mereka lupa membatasi pembuatan insiden (create incident). Hasilnya, akun Platform Agent masih bisa membuat insiden baru untuk tim Infra.
- Asset serving (Infrastructure Bug - 3 pts):
Ketiganya lupa mendaftarkan static asset router di Fastify untuk berkas
/public/app.js. Karena berkasnya gagal dimuat (HTTP 404), fitur progressive enhancement jadi mati total. - Debounced Search (UX Bug - 5 pts):
Taktik progressive enhancement untuk pencarian debounce gagal meng-update URL browser ke
/incidents?q=....
Ini membuktikan bahwa kita tetap butuh mekanisme verifikasi mandiri atau back pressure5 di kontrak prompt kita. Jangan cuma menyuruh AI “buatkan aplikasi A”, tapi paksa mereka untuk membuktikan kalau tidak ada kebocoran authorization secara server-side.
Kesimpulan: Pilihan Akhir Workflow-ku #
Pengujian ini membuka mataku kalau DeepSeek beneran siap dipakai di workflow ngoding sehari-hari. Dengan biaya yang cuma sepeser ($0.21), performa kodingnya setara dengan model yang harganya 10x lipat lebih mahal.
Untuk workflow-ku sekarang, skema idealnya adalah menggunakan DeepSeek sebagai daily driver untuk eksplorasi kode awal dan menulis draf modular, lalu membawa catatan serah terima (handoff notes) ke Gemini 3.5 Flash jika butuh polesan visual UI kelas premium atau pemecahan logika arsitektur yang super rumit.
Kalau kalian sendiri, sudah coba pakai model China yang mana buat ngebantu ngoding?